当AI开始替你读代码:C#程序的防AI逆向与英文单词混淆
前段时间和一位做桌面软件的朋友聊天,他说自己的程序被人“研究”了。对方没有花几天去啃反编译结果,只是把导出的代码丢进 AI 对话框,反复问了几轮,就摸清了授权校验的位置。
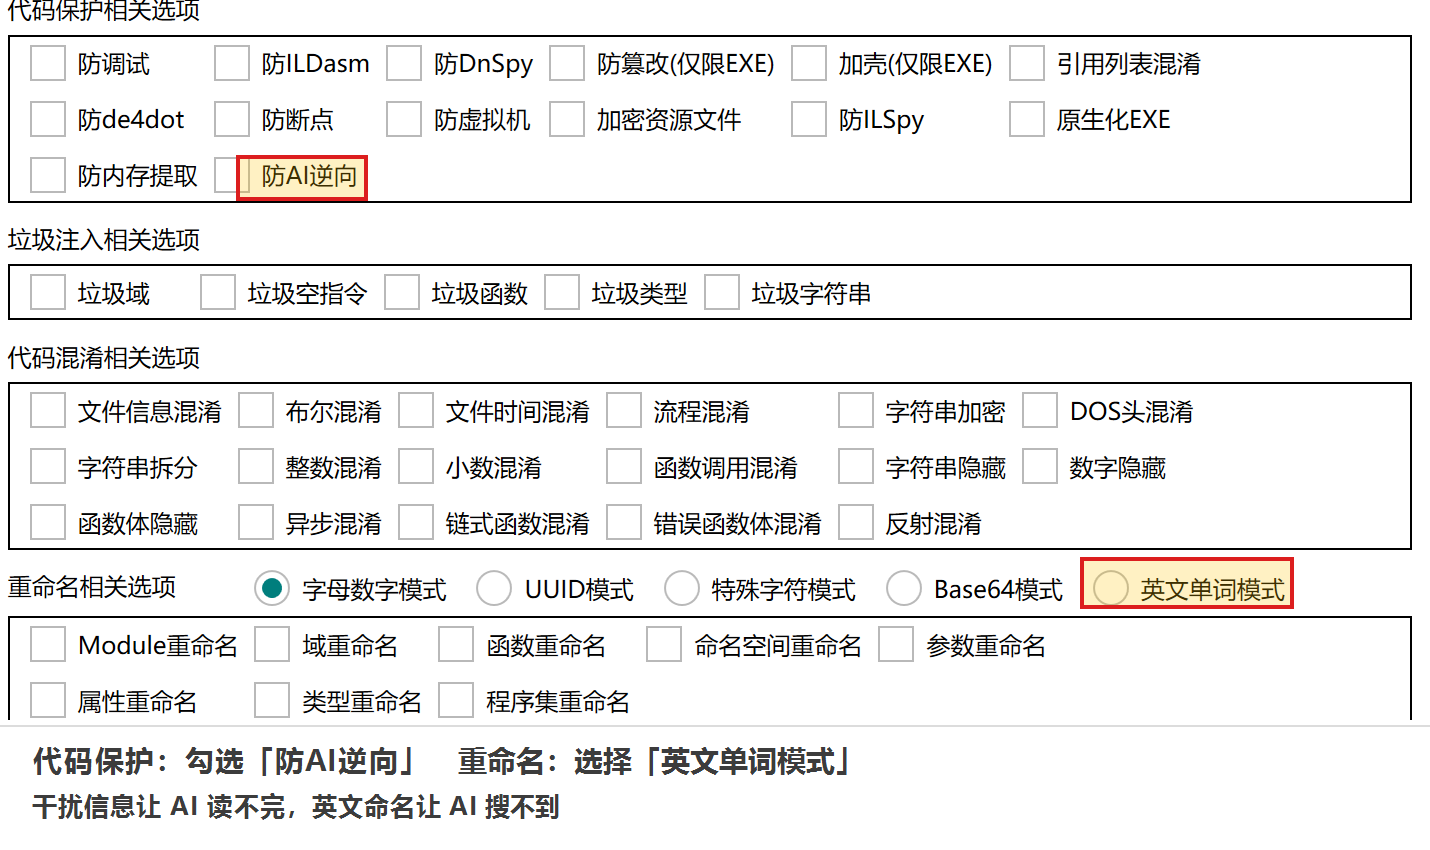
这件事说明的问题不是“他的代码写得太简单”,而是逆向这件事的成本结构变了。恒盾C#混淆加密大师近期更新的防AI逆向选项,以及搭配使用的英文单词模式,正是冲着这个变化去的。
逆向的门槛,被AI重新定义了一次
过去评价一个程序“好不好保护”,看的是它需要分析者付出多少专业能力:要会看 IL、要能对付反编译工具、要懂调试、要有耐心。
AI 把这几项拆开重算了:
- 专业门槛下降:分析者不需要完全读懂代码,只需要会描述问题、会追问。
- 处理量不再是瓶颈:一次几十个类、上百个方法,可以整段交给 AI 先做筛选。
- 耐心不再稀缺:人看代码会累,AI 不会。看不懂就换个问法,一直问到有结论为止。
于是,很多传统保护手段的假设开始松动。它们大多建立在“看不懂就会放弃”之上,而现在,看不懂只是意味着多问几轮。
传统混淆的三个假设
假设一:代码越乱,人越容易放弃。
流程混淆、函数体隐藏、字符串加密,确实能让反编译结果难读。但 AI 的价值恰恰在于处理“大量且混乱”的内容——乱,对它来说不是障碍。
假设二:工具打不开,分析就无法开始。
防 ILSpy、防 DnSpy、防 de4dot 这些选项依然有用,它们拦住的是“顺手看一眼”的人。但愿意花时间的人,总能找到能打开的角度。
假设三:名字没有意义,就没法搜索。
这条最接近失效。字母数字、UUID、Base64 这类命名确实失去了语义,可它同时也暴露了一个信号:这个程序被混淆过。有经验的分析者看到这种命名,会立刻切换策略,从字符串、调用关系、资源文件去找入口;AI 也能顺着同样的线索继续推。
换句话说,传统重命名解决的是“读起来费劲”,但它没能解决“搜起来费劲”。
防AI逆向:目标不是“读不懂”,而是“读不完”
勾选这个选项后,程序内部会被加入大量干扰信息,与真实业务代码混在一起。它不改变程序的运行逻辑,也不打算让反编译工具报错,它做的是另一件事:把分析这件事的规模放大。
对 AI 来说,这带来两个连锁反应。
第一,分析容量被挤占。AI 一次能处理的内容是有限的,干扰信息越多,真正有价值的代码占比就越低。当分析者把整个程序丢进去时,最先被读到的往往是大量无关内容,关键代码排在后面,甚至根本没能进入这一轮——也就是“上下文溢出”。
第二,判断质量下降。在一堆看起来很相似的代码里,AI 更容易给出似是而非的结论。分析者拿到的不是“答案”,而是一份需要逐个验证的候选清单。
这个思路可以用一个比喻来理解:传统混淆是把一页纸写得很潦草,防AI逆向则是把一页纸变成一千页,其中只有一页是真的。前者考验耐心,后者考验成本。
英文单词模式:可读,但不是给你的可读
如果只做干扰,还有一个漏洞:分析者仍然可以用关键词搜索,把范围迅速缩小。
这正是英文单词模式有意思的地方。它反直觉地把函数、类型、字段、参数重命名成正常的英文单词组合,而不是一串乱码:
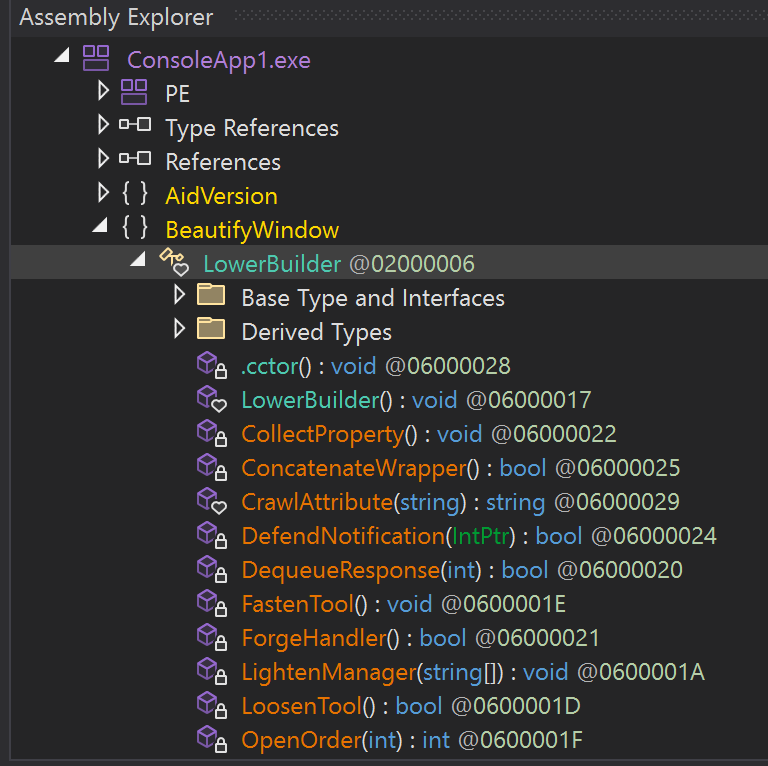
从分析者视角看,这个程序“看起来很正常”:
- 没有明显的混淆痕迹,不会触发“这是被处理过的”警觉;
- 每个名字都像业务代码,但语义全部被抹平;
- 想搜
license、auth、verify、trial、expire,很可能一条都搜不到; - 即使搜到了,也可能同时命中几十个同样“像那么回事”的位置,无法判断哪个是真的。
这就是它和字母数字模式最大的差别:乱码会告诉对方“这里有保护”,而普通英文单词不会。 一个制造警觉,一个制造幻觉。
当英文单词模式和防AI逆向同时启用,两件事会叠加发生:搜索定位失效,读的时候又读不完。分析者面对的就不再是“一段难懂的代码”,而是一片没有路标、也走不到尽头的区域。
保护其实是有层次的
把可用的手段按分析者会遇到的顺序排一下,会更容易理解它们各自的位置:
- 打不开:防 ILSpy、防 DnSpy、加壳、原生化,让对方连代码都拿不到完整的。
- 读不完:防AI逆向注入大量干扰信息,让拿到代码也无法一次性分析完。
- 搜不到:英文单词模式抹平命名语义,让关键词检索失去作用。
- 改不动:防篡改、强名称、加壳校验,让修改后的程序无法正常运行。
- 绕不过:把真正的授权判定放在服务端,客户端只是一个凭证。
大部分程序只需要覆盖其中两三层。指望单独一个选项解决所有问题,往往会在真实对抗中失望。
谁适合用,谁不必用
适合:带授权或注册机制的商业软件、需要交付给客户的 DLL 组件、Unity 游戏、企业内部工具、包含行业算法的小型桌面程序。这些场景的共同点是——程序必须交到用户手里,而你又不想让核心逻辑变成公开读物。
不太必要:开源项目、一次性脚本、内部完全可控且无商业价值的工具。给这类程序加保护,增加的只是自己的维护成本。
几个容易踩的误区
“混淆等于加密。”
不是。混淆是提高理解成本,加密是让内容不可读。两者的强度、代价和适用场景都不同。
“勾得越多越安全。”
选项之间存在兼容性影响,也可能与程序里的反射、序列化、第三方框架冲突。全勾的结果通常是:保护没测出来,程序先跑不起来。
“英文单词模式就是好看一点。”
它的价值不在好看,而在于让“命名”这条线索失效。名字越像正常代码,检索越没有方向。
“客户端保护做好了,授权就安全了。”
客户端永远在对方手里。保护的作用是把破解成本抬高、把批量破解变得不划算,而不是让破解不可能。
一点必要的诚实
防AI逆向不是“AI 无法分析”的承诺。它做的是一件更现实的事:让 AI 辅助分析从“几分钟出结论”变成“需要反复切分、比对、验证”的长流程。对多数商业软件来说,这个成本差已经足够形成门槛。
同时也别忽略代价:程序体积会变大,处理时间会变长,部分依赖名称的代码需要加入忽略列表。发布前该做的测试,一个都不能省。
最后
AI 没有让代码保护变得没有意义,它只是把保护的重点从“让人看不懂”推向了“让人算不过来”。
防AI逆向负责抬高阅读成本,英文单词模式负责切断检索线索——一个让人读不完,一个让人找不到。对于还在用“改个乱码名字”当保护的 C# 项目来说,这大概是今年最值得补上的一课。
软件的最新版本可以在官网获取:恒盾C#混淆加密大师